Die Hochverfügbarkeit eines PostgreSQL-Clusters, der in mehreren Rechenzentren bereitgestellt wird, basiert auf Replikation, die synchron oder asynchron erfolgen kann (siehe Replikationsmodi ).
In beiden Fällen ist es wichtig, die folgenden Konzepte klar zu verstehen:
- PostgreSQL kann nur als primärer oder sekundärer Knoten betrieben werden, wenn es den Schlüssel besitzt und diesen aktualisieren kann.
- Sie sollten eine ungerade Anzahl von etcd-, ZooKeeper- oder Consul-Knoten betreiben: 3 oder 5!
Synchrones Replikation
Um einen mehrere Rechenzentrum (DC) umfassenden Cluster zu haben, der automatisch einen Ausfall einer Zone tolerieren kann, sind mindestens 3 erforderlich.
Das Architekturdiagramm hätte folgende Gestalt:
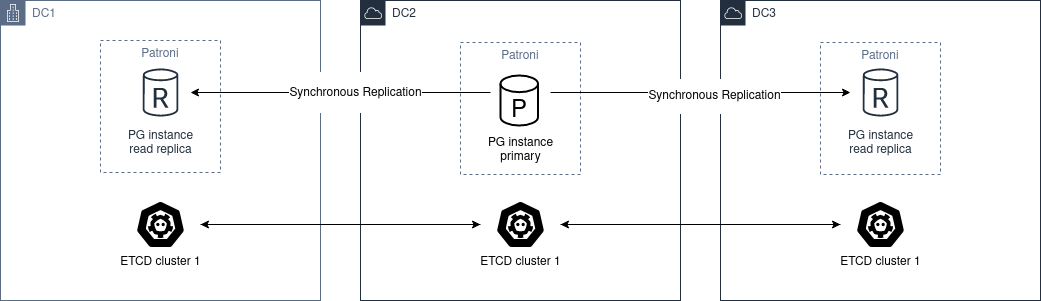
Sie müssen einen Cluster aus etcd, ZooKeeper oder Consul über verschiedene Rechenzentrum (DC) hinweg bereitstellen, wobei mindestens 3 Knoten erforderlich sind, jeweils ein Knoten pro Zone.
Bezüglich PostgreSQL müssen Sie mindestens 2 Knoten in unterschiedlichen Rechenzentrum (DC) bereitstellen. Anschließend müssen Sie synchronous_mode: true in der globalen dynamic configuration
festlegen.
Dies aktiviert die synchrone Replikation, und der Primärknoten wählt einen der Knoten als synchron aus.
Asynchrone Replikation
Mit nur zwei Datenzentren ist es besser, zwei unabhängige etcd-Clustern zu haben und einen Patroni Standby-Cluster im zweiten Datenzentrum auszuführen. Falls das erste Standort down geht, kann der standby_cluster MANUALLY promoviert werden.
Das Architekturdiagramm wäre folgendes:
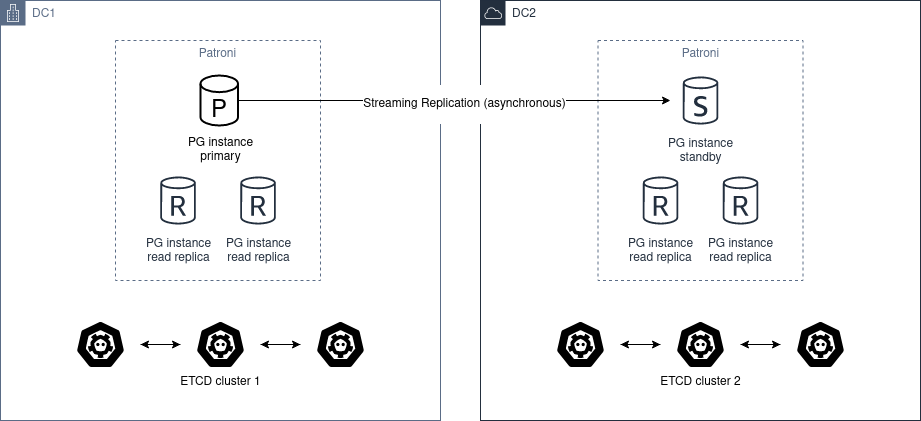
Automatische Erhöhung des Status ist nicht möglich, da DC2 niemals in der Lage sein wird, den Zustand von DC1 zu ermitteln.
Sie sollten pg_ctl promote in diesem Szenario nicht verwenden, Sie müssen die gesunde Clusterkonfiguration manuell erhöhen, indem Sie den standby_cluster
Abschnitt aus der dynamischen Konfiguration
entfernen.
Wenn das Quellcluster noch aktiv läuft und Sie den Standby-Cluster erhöhen, erzeugen Sie eine Split-Brain-Situation.
In der Regel gibt es nur zwei Möglichkeiten, um zur “ursprünglichen” Situation zurückzukehren:
- Fügen Sie den standby_cluster-Abschnitt wieder hinzu, um
pg_rewindauszulösen; jedoch musspg_rewindordnungsgemäß funktionieren, dass der Cluster mitdata page checksumsinitialisiert werden muss (die--data-checksums-Option fürinitdb), und/oderwal_log_hintsaufongesetzt werden muss, aber es besteht immer noch die Möglichkeit, dasspg_rewindaufgrund anderer Faktoren fehlschlägt. - Erstellen Sie den Standby-Cluster von Grund auf neu.
Bevor Sie den Standby-Cluster erhöhen, müssen Sie sicherstellen, dass das Quellcluster heruntergefahren ist (STONITH). Wenn DC1 wiederherstellt, muss das Cluster in einen Standby-Cluster umgewandelt werden.
Bevor Sie dies jedoch tun, können Sie die Datenbank manuell überprüfen und alle Änderungen extrahieren, die zwischen dem Zeitpunkt festgestellt wurden, an dem die Verbindung zwischen DC1 und DC2 nicht mehr funktioniert, und dem Zeitpunkt, an dem Sie den Cluster in DC1 manuell gestoppt haben, stattgefunden haben.
Nachdem Sie diese Änderungen extrahiert haben, können Sie diese auch manuell auf den Cluster in DC2 anwenden.